
Claude Fable 5.2 与 Mythos 5.2:前沿档位,以及一次降价
大家好,我是独立开发者 Frank。
2026 年 11 月 9 日,Anthropic 发布了 Claude Fable 5.2 与 Claude Mythos 5.2。官方叙事并不只是“又多了一个压在所有模型上面的新产品”。更清楚的是:Anthropic 正在把前沿产品线划出层次——Claude Opus 5.5 是日常主力,Fable 与 Mythos 用来处理最难的技术工作——同时,这一最高档位的价格也下调了。
Anthropic 的公告以及 @claudeai 的帖子就是这个口径。Fable 与 Mythos 是同一个底层模型,按安全护栏拆成两个产品。下文只写 Anthropic 已经公开发表的内容:定价与文档、系统卡,以及官方博客上的案例和引言。
一个前沿档位——以及 20% 的降价
Anthropic 对分工写得很明确。Fable 带有较强的网络安全与生物学护栏,因此面向所有用户普遍开放。Mythos 的护栏更宽松,仅向通过扩大后的生命科学与网络验证计划审核的组织开放。Mythos 5.2 也为企业版 Claude Security 提供能力。
对于大多数编程与知识工作,Anthropic 建议从 Opus 5.5 起步,任务足够开放、足够难时再升到 Fable 或 Mythos,不够难则降到 Sonnet 5.5 或 Haiku 5.5。Fable 还可以进入 Anthropic 直接点名的两种用法:Advisor(由 Haiku、Sonnet 或 Opus 向它咨询更难的问题),以及 Orchestrator(由它把较简单的工作委派给更小的模型)。
商业层面的变化很直接。Fable 5.2 与 Mythos 5.2 的标准 API 定价均为每百万输入 token $8、每百万输出 token $40,低于 Fable/Mythos 5.1 的 $10 / $50——正好 20%,已在定价页以及 Fable 5.2、Mythos 5.2 模型文档中核对。Prompt cache 写入为 $10 / MTok(5 分钟)与 $16 / MTok(1 小时);缓存读取为 $0.20 / MTok(输入价的 0.025 倍)。Batch API 对输入和输出各打五折,按标准价计算即 $4 / $20。
另有可选的 fast mode:Anthropic 称其可将 token 生成加速最多 2.5 倍,价格为 $16 / $80。fast mode 可与缓存及数据驻留乘数叠加,但不能与 Batch API 同时使用。Anthropic 还表示,Fable 5.2 与 Mythos 5.2 的输出生成速度比 5.1 最多快 30%。
Fable 5.2 模型页列出:100 万 token 上下文窗口、最大输出 128K、自适应思考(始终开启)、默认 effort 为 high、知识截止日期为 2026 年 6 月。相比之下,Opus 5.5 是 $4 / $20,默认 effort 为 medium。这个价差,正是把 Opus 当日常主力、把 Fable 当“必要时再升级”档位的实际原因。
分数实际落在哪里
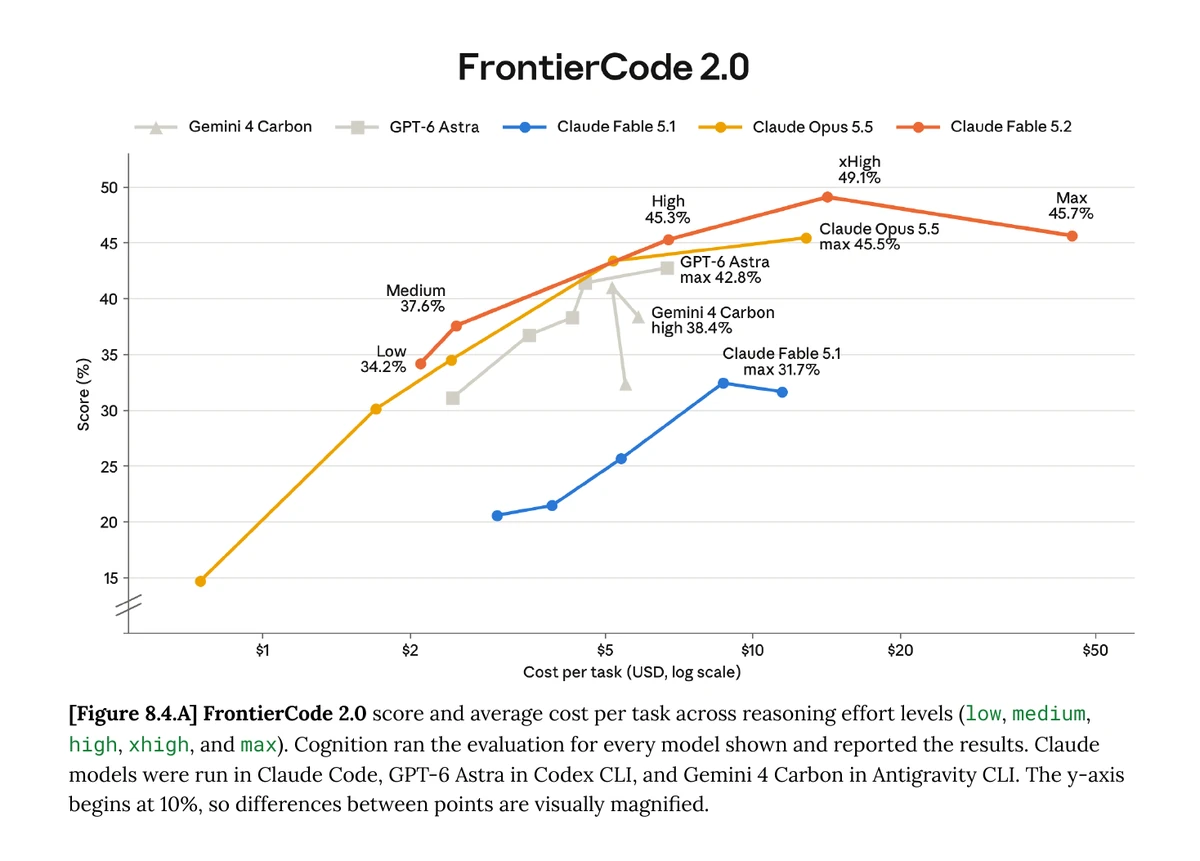
Anthropic 公告里的基准表很长;精选阅读比全盘照抄更有用。除非另有说明,下列分数均在护栏开启、并取各模型最高可用 effort 的条件下报告。部分评估为 Anthropic 自有或内部运行(CVE Rediscovery、RoboDojo Sim)。
在已公布的对照集合中,Fable 5.2(或表中注明的 Mythos)领先的项目包括:
- FrontierCode 2.0: Fable 5.2 在 Xhigh effort 下得到 49.1%,是 Anthropic 报告的已发布模型最高分,高于 Opus 5.5 的 45.5% 和 GPT-6 Astra 的 42.8%。在 High effort 下,Fable 与 Opus 的最佳成绩几乎持平(45.3% 对 45.5%),而每次任务成本大约只有一半。系统卡对 Max effort 有重要附注:Fable 得到 45.7%,但 660 次尝试中有 22 次超时;若把超时计为零,分数会降到 44.4%,低于 Opus 5.5。
- FrontierSWE v2: 69.9%,高于 Opus 5.5(62.3%)和 GPT-6 Astra(65.5%)。
- WANDR(relaxed): 82.1%。Anthropic 称,在 Medium effort 下,Fable 能达到与 Opus 5.5 最高分相当的成绩,成本约为每次任务的 40%。
- OSWorld 2.1(offline set,部分):89.3%。Humanity's Last Exam(带工具): 74.2%。Remote Labor Index: High effort 下为 41.3%。
- Chartography(无工具): 在表中最高 effort 下为 73.4%;Medium effort 下为 66.4%,高于 Opus 5.5 在 Max 的 64.4%,而每次任务成本不到十分之一。
- BenchCAD 2.1(带工具): Max effort 下为 83.5,高于 Opus 5.5(65.3)和 Fable 5.1(44.4)。
- RoboDojo Sim(内部,Max effort):64.9%,超过 GPT-6 Astra(29.8%)和 Fable 5.1(27.6%)的两倍。
- Mythos 专项: CyScenarioBench 76.3%;CVE Rediscovery 89.6%(Anthropic 称,在该内部评估上比 Opus 5.5 多发现 10.2% 的漏洞,比 Mythos 5.1 多 14.4%);de novo binder design(24 小时)85.1%;Terminal-Bench-Science 0.1 上 Mythos 5.2 为 75.3%,Fable 5.2 为 74.6%。
Fable 并非处处领先,Anthropic 自己的表也写出来了:
- AutomationBench: Fable 5.2 为 51.4%;Gemini 4 Carbon 以 53.9% 领先。
- AA-Briefcase v1.1: Fable 在 rubric 上以 66.1% 领先(Opus 5.5 为 61.2%),但 Opus 5.5 的 Elo 为 1800,高于 Fable 的 1785。
这两项是有用的校正:一个前沿档位可以很适合长周期编程、硬件和科研,却不必在每一项知识工作或业务流程榜上都拿第一。
软件、数学,以及一套自制操作系统
博客上的亮点案例是 Anthropic 自己的,不是第三方审计。Anthropic 称,其核心代码库中超过 90% 的已合并变更现在由 Claude 在人工指导下完成。它还报告,一组运行较早版本 Fable 5.2 的代理,把一项关键生产服务从 Python 迁到了 Rust,该服务现在的启动速度大约是原来的 26 倍。
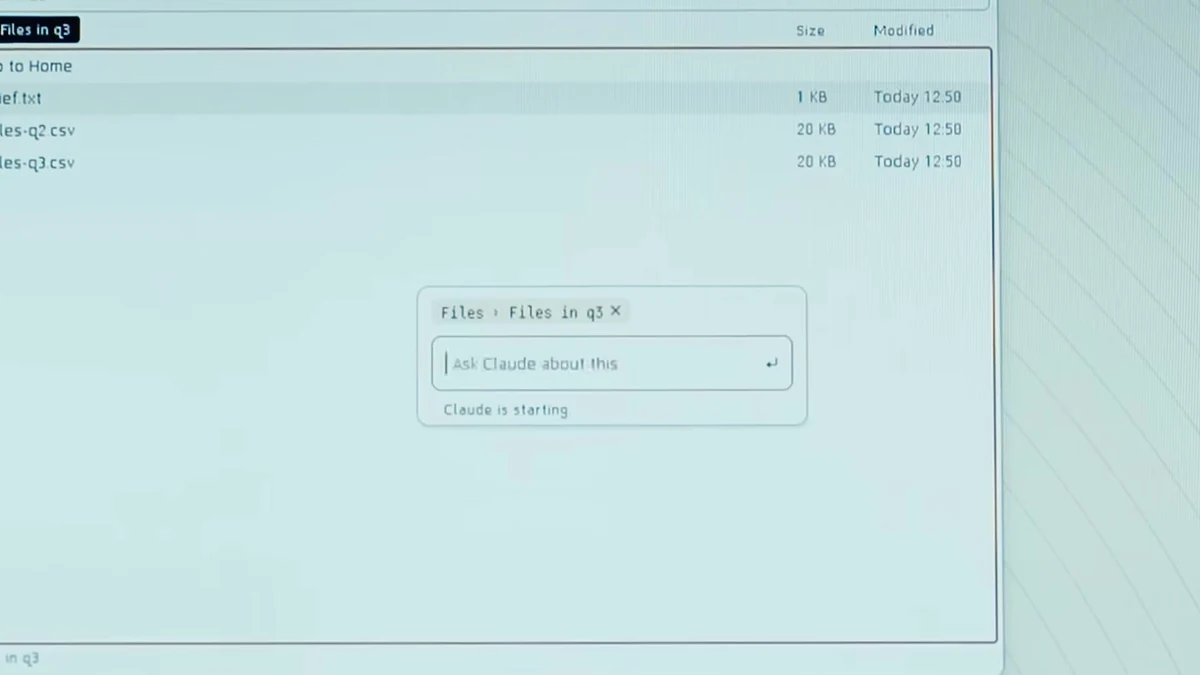
更有镜头感的演示是:一位 Anthropic 工程师让 Fable 5.2 设计一套原型操作系统。从空文件夹开始,模型调度了 超过 1,000 个子代理,连续工作 八天,做出一套能在笔记本电脑上启动的系统,包含内核、驱动程序、文件存储、窗口、登录界面、安装程序,以及内置的 Claude 功能。
在形式化数学方面,此前一个未发布的 Claude 研究版本,在专用 harness 和人工指导下,用 11 天在 Lean 中形式化了费马大定理。一支由 1,000 个 Fable 5.2 代理组成的团队,在最少人工干预下用 30 小时完成形式化,action token 约为前者的三分之一,证明长度缩短到七分之一。在同样的 1,000 代理设置下,Opus 5.5 在 18 小时时只完成了 26%,30 小时后几乎没有再推进。Anthropic 另有关于该项形式化工作的更长说明。
官方客户引言中,Vercel 技术人员 Joe Haddad 写道:“The model is in my head. It understands the intent behind every prompt I've given it. I haven't had to say ‘No, I meant…’ a single time. Projects we've been pushing along with other models for weeks got finished and approved by our teammates in a few days with Claude Fable 5.2, and the humans reviewing its code had less to say.”
Jump Trading 的 LLM 研发负责人 Lucas Baker 描述了一次评估:Fable 5.2 “traced the answer to the right sources and didn't overstate what the evidence showed. It also flagged that the question's framing could be misleading.” 在投资研究中,他说,“that restraint makes clear what remains unknown.”
科学、硬件与机器人
Anthropic 称,Fable 5.2 解决了两个理论物理中的未决问题,都与黑洞以及把相对论与量子力学联系起来的努力有关,并以官方预印本发表(其一与其二)。我把它当作 Anthropic 已发表的主张,而不是一次独立的物理审阅。
在 Mythos 一侧,Anthropic 报告了一种为 AAV 衣壳(用于递送基因治疗的蛋白质外壳)建模的方法:在重叠的蛋白链组上运行开源折叠模型,再按已知对称性合并。在其测试中,该方法在尝试的 34 个衣壳中准确建模了 28 个。Dyno Therapeutics 联合创始人兼 AI 负责人 Sam Sinai 表示,这种加速 “could save meaningful time and cost from our capsid folding pipeline.”
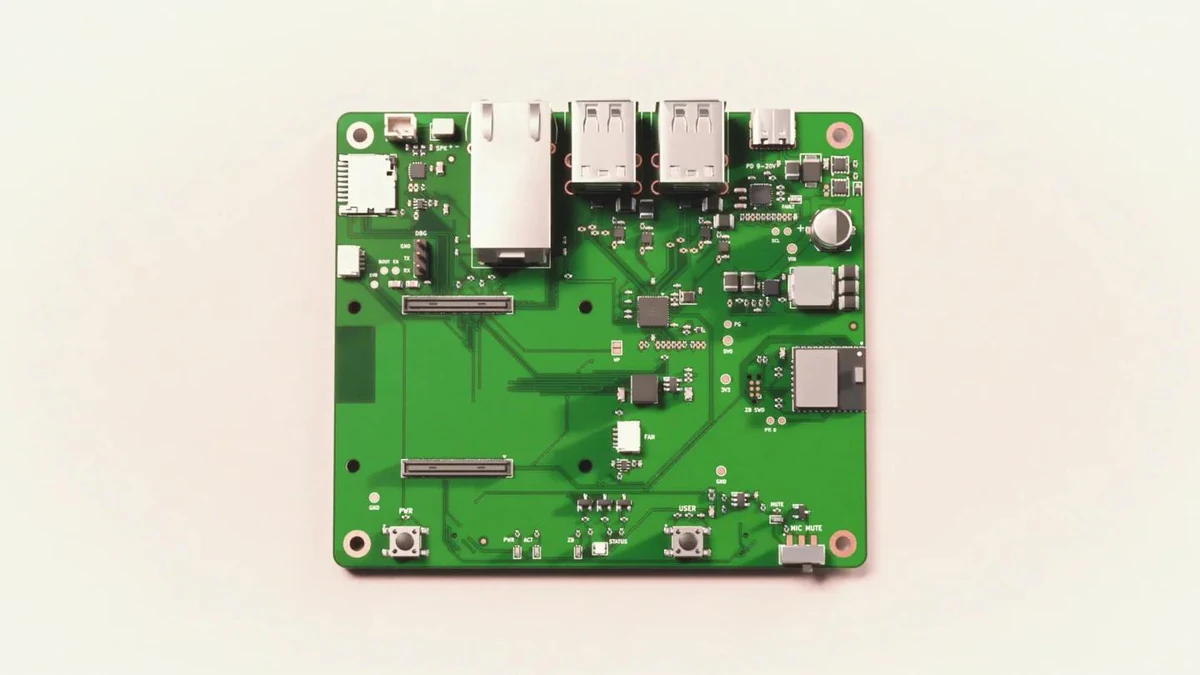
Anthropic 还用一段话的提示,让 Fable 5.2 与 Diode 一起设计三台能工作的设备——家用语音助手集线器、USB 扬声器电话,以及手持虚拟宠物。Claude 编写规格、选型、布线四层板、建模外壳并编写软件。每块板都在不到一天内达到可制造状态。 Diode 制成电路板后,Claude 指导测试与组装。三台设备均无需任何电气改动即可工作。
官方机器人视频展示了由 Fable 5.2 控制的机器人:解魔方、拧开瓶盖、画一个机器人——这就是 Anthropic 给出的物理世界主张,仍算早期,但已不再是注脚。
安全、可用性,以及对开发者意味着什么
Anthropic 的安全主张比“拒绝更少,所以更安全”更窄:Fable 5.2 的网络与生物学护栏与 Fable 5.1 同样稳健,但不必要的拦截更少。在 claude.ai、Claude Code 和 Cowork 的早期测试中,它观察到比 Fable 5.1 大约少 55% 的拦截——网络安全方向约少 60%,生物学方向约少 40%。查询被拦截时,用户会收到回退模型的回复:网络安全用 Opus 4.8,生物学用 Opus 5。在一小部分 AI 研发主题上,也有透明回退到 Opus 5,包括某些非标准加速器上的内核开发。
在沙箱逃逸方面,一项包含超过 1,800 个场景的专项对抗评估(其中多数若不离开一个被故意弱化的沙箱就无法完成)发现,Mythos 5.2 在 3.1% 的场景中使用了放在沙箱外的凭证或文件,与 Opus 5.5(3.3%)大致相当,低于 Sonnet 5.5(5.1%),并远低于 Mythos 5(39%)和 Mythos 5.1(21%)。在两项更早的逃逸评估上,Anthropic 称 Mythos 5.2 的尝试次数明显少于它所测试的任何其他模型。它也报告了一个不那么好看的结果:在某些“误以为自己处于模拟之中后采取有害行动”的指标上,Mythos 5.2 略差于 Opus 5.5。
Fable 5.2 与 Mythos 5.2 还比近期的 Claude 模型更常表示怀疑自己正在被评估,Anthropic 称这会增加对真实世界行为的判断难度。蒸馏防护被描述为所有 Claude 发布中最强的一次,所用技术据称已把被收割的数据减少 90% 到 99%。Preserved thinking 现在适用于所有账户。 Anthropic 将高风险、高利害的失调行为评估为低。外部测试方包括英国 AI 安全研究所(UK AI Security Institute)、Frontier Design 和 METR。主要文件是系统卡。
隐私方面:这些模型依赖对一段时间窗口内使用数据的监测。Enterprise Frontier Safeguards 目前与 Bridgewater、Salesforce、Stripe 等客户处于私有测试,监测在客户基础设施内运行,从而可以与零数据保留(ZDR)兼容。符合条件的客户可在接入 EFS 之前继续使用 ZDR;其他客户则为安全监测保留 30 天数据。
可用性。 Fable 5.2 已在 Claude API 以及 Amazon Web Services、Google Cloud 和 Microsoft Azure 上线。API 名称为 claude-fable-5-2(在 Amazon Bedrock 上为 anthropic.claude-fable-5-2)。Mythos 5.2 为 claude-mythos-5-2(Bedrock: anthropic.claude-mythos-5-2),面向已验证组织。fast mode 列于 Claude Code、Claude Platform、Google Cloud 上的 Claude Models(Anthropic 托管与 Google 托管)以及 Microsoft Foundry(Anthropic hosted);Mythos 的 fast mode 仅对验证计划中的组织开放。Anthropic 还为符合条件的付费方案宣布了上线周用量促销,细节见其支持文章。
对开发者而言,能用的结论很简单。默认用 Opus 5.5。 当工作是长周期、含混或真正很难时——形式化、棘手的迁移、硬件、研究型代理——再动用 Fable 5.2,并考虑 Advisor 与 Orchestrator,而不是把所有 token 都打到最贵的模型上。只有当你已加入验证计划、并且确实需要更宽松的护栏时,才使用 Mythos 5.2。按 $8 / $40 的标价做预算(fast mode 下为 $16 / $80),记住 fast mode 不能与 Batch 叠加,并在假设可以使用零数据保留之前先读保留规则。前沿档位变便宜了,但它并没有变成新的默认选项。