2026 年 AI 模型评分与成本:开发者如何看 Artificial Analysis
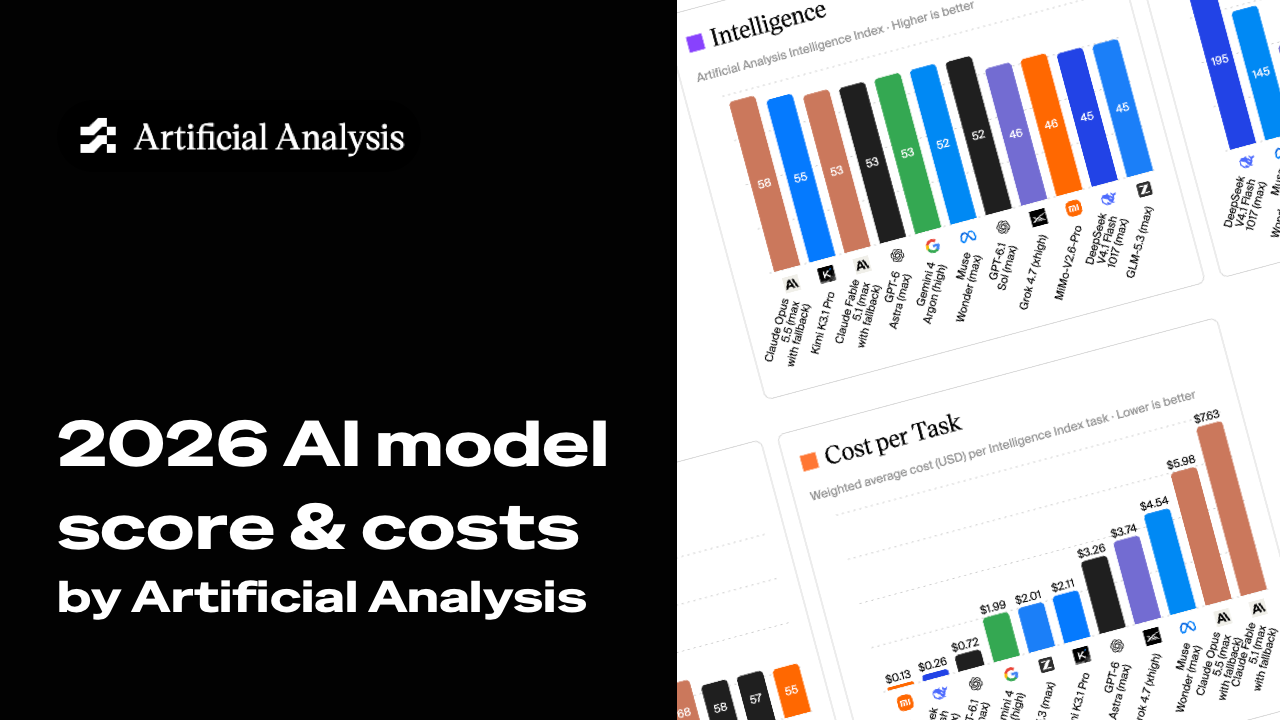
数据核对日期:2026 年 10 月 24 日;Artificial Analysis Intelligence Index v4.3.2。 开发者选模型时,能力和成本最好放在一起看。Artificial Analysis 同时公布智能指数,以及模型完成其评测任务时的平均 API 成本。以下是有代表性的模型,并非完整榜单;最新数字请以实时榜单为准。
分数与成本分别代表什么?
智能指数综合十项评测,覆盖 Agent 任务、编程、通用知识和科学推理。v4.3.2 对这四类能力的权重分别是 30%、20%、30% 和 20%。评测以英文文本任务为主;图像输入和多语言能力另行评估。50 分不等于 50% 的任务成功率;按 30、40、50 分理解模型档位,只是一种方便阅读的分组,并非官方等级。查看评分方法。
“每任务成本”指完成一项智能指数评测任务的加权平均 API 成本,单位为美元。它根据模型实际消耗的输入、缓存和输出 token 及对应价格计算,并不是你产品里每次提问都会花这么多。长时间运行的 Agent、简短聊天和高缓存命中率的应用,账单可能相差很大。查看成本定义。
模型分数与成本速览
括号中的推理强度很重要:同一模型换一个档位,分数和成本都可能变化。
50 分以上:复杂任务的候选
- Claude Opus 5.5(max,默认 fallback):58 分;每任务 5.98 美元。本列表中得分最高,评测成本也较高。
- Claude Sonnet 5.5(max,默认 fallback):56 分;每任务 5.46 美元。高强度推理下的 Sonnet,也未必是低成本选择。
- Kimi K3.1 Pro:55 分;每任务 2.11 美元。分数接近前两者,测得成本更低。Artificial Analysis 在 10 月 23 日发布首发分析时,其模型权重尚未发布。
- GPT-6 Astra(max):53 分;每任务 3.26 美元。它的每百万 token 标价高于 Opus 5.5,但评测任务成本反而更低,说明 token 用量也会改变最终账单。
- GPT-6.1 Sol(max):52 分;每任务 0.72 美元。达到 50 分以上,同时保持较低的测评任务成本。
40 分和 30 分档:低成本起点
- GLM-5.3-Flash:42 分;每任务 0.28 美元。开放权重模型,测得 API 成本较低。
- GPT-6 Luna(high):33 分;每任务 0.03 美元。可作为简单任务或大批量任务的低成本候选。
这些“档位”只是本文的阅读方式,并非 Artificial Analysis 的认证等级。另一个 50 分以上的模型 Muse Wonder Full(max)得分为 56,但它不按 token 计价,因此官网没有可直接比较的每任务成本。查看相关报告。
开发者该怎么用这份列表?
- 从自己的任务出发。 分类、信息提取和初稿生成,可以先测试低成本模型;输出失败代价较高的任务,再考虑高分配置。
- 比较同一推理档位。 同一模型家族可能横跨多个分数与成本点。评测时记下具体版本、服务商和缓存设置。
- 计算自己的“成功任务成本”。 用真实请求样本测试质量,并把重试、工具调用和延迟计入评估。榜单上每任务最便宜的模型,未必是你的应用里稳定交付最便宜的模型。
Artificial Analysis 很适合做能力与成本的第一轮筛选。最终上线前,仍应核对实时数据,并针对自己的工作流做一轮小规模评测。