KI-Modelle 2026: Bewertungen und Kosten im Vergleich von Artificial Analysis
Datenstand: 24. Oktober 2026 · Artificial Analysis Intelligence Index v4.3.2. Wer ein Modell für eine Anwendung auswählt, sollte Leistung und Kosten gemeinsam betrachten. Artificial Analysis veröffentlicht dafür einen Intelligence Index und die geschätzten API-Kosten seiner Evaluationsaufgaben. Die folgende Auswahl ist keine vollständige Rangliste; aktuelle Werte stehen im Live-Ranking.
Was messen Punktzahl und Kosten?
Der Intelligence Index fasst zehn Evaluationen zu Agentenaufgaben, Programmierung, Allgemeinwissen und wissenschaftlichem Schlussfolgern zusammen. In Version 4.3.2 werden diese vier Bereiche mit 30 %, 20 %, 30 % und 20 % gewichtet. Die Tests bestehen überwiegend aus englischsprachigen Textaufgaben; Bildeingaben und Mehrsprachigkeit werden getrennt bewertet. 50 Punkte bedeuten keine Erfolgsquote von 50 %. Gruppen wie „30er“, „40er“ und „50er“ helfen beim Lesen, sind aber keine offiziellen Güteklassen. Methodik ansehen.
„Kosten pro Aufgabe“ bezeichnet die gewichteten durchschnittlichen API-Kosten in US-Dollar für eine Aufgabe des Intelligence Index. Grundlage sind tatsächlich verbrauchte Eingabe-, Cache- und Ausgabetokens sowie deren Preise. Der Wert ist kein Festpreis für eine Anfrage in der eigenen Anwendung: Längere Agentenläufe, kurze Chats und Workloads mit hohem Cache-Anteil können stark voneinander abweichen. Kostendefinition ansehen.
Bewertungen und Kosten im Überblick
Die Denkstufe in Klammern ist Teil der Modellkonfiguration. Eine andere Stufe kann sowohl Punktzahl als auch Kosten verändern.
Ab 50 Punkten: Kandidaten für anspruchsvolle Abläufe
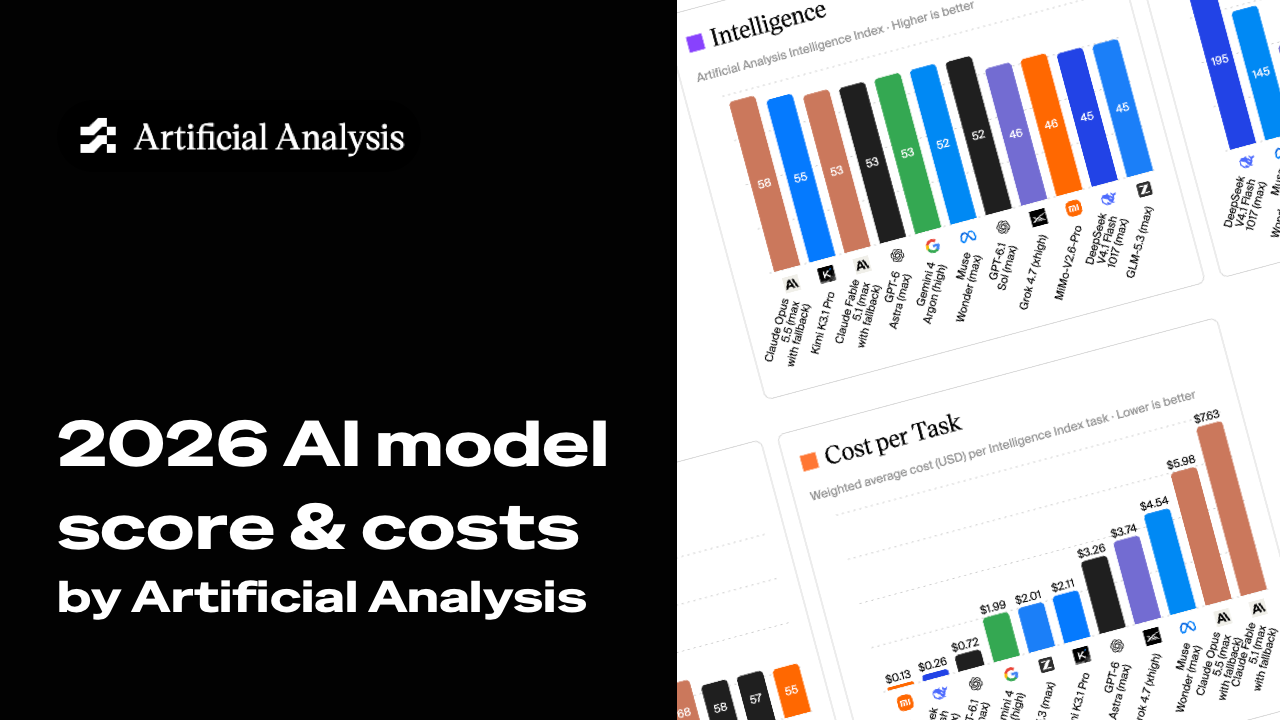
- Claude Opus 5.5 (max, Standard-Fallback): 58 Punkte; 5,98 $ pro Aufgabe. Höchste Punktzahl dieser Auswahl, bei deutlich höheren Benchmark-Kosten.
- Claude Sonnet 5.5 (max, Standard-Fallback): 56 Punkte; 5,46 $ pro Aufgabe. Auch Sonnet ist bei maximaler Denkstufe nicht automatisch günstig.
- Kimi K3.1 Pro: 55 Punkte; 2,11 $ pro Aufgabe. Eine hohe Bewertung bei niedrigeren gemessenen Kosten als die beiden vorgenannten Modelle. Zum Zeitpunkt des Berichts vom 23. Oktober waren die Modellgewichte noch nicht veröffentlicht.
- GPT-6 Astra (max): 53 Punkte; 3,26 $ pro Aufgabe. Sein Listenpreis pro Million Tokens liegt über dem von Opus 5.5; die Benchmark-Aufgabe kostet trotzdem weniger. Der Tokenverbrauch beeinflusst also die Gesamtkosten.
- GPT-6.1 Sol (max): 52 Punkte; 0,72 $ pro Aufgabe. Eine Bewertung über 50 bei wesentlich niedrigeren gemessenen Aufgabenkosten.
40er und 30er: günstigere Ausgangspunkte
- GLM-5.3-Flash: 42 Punkte; 0,28 $ pro Aufgabe. Ein Modell mit offenen Gewichten und niedrigen gemessenen API-Kosten.
- GPT-6 Luna (high): 33 Punkte; 0,03 $ pro Aufgabe. Ein preiswerter Kandidat für einfachere Aufgaben oder hohe Anfragezahlen.
Diese Gruppen sind eine redaktionelle Orientierung, keine Zertifizierungsstufen von Artificial Analysis. Muse Wonder Full (max) erreicht ebenfalls 56 Punkte, hat aber keinen vergleichbaren Wert für „Kosten pro Aufgabe“, da es nicht pro Token abgerechnet wird. Bericht lesen.
So können Entwickler die Liste nutzen
- Mit dem eigenen Anwendungsfall beginnen. Für Klassifikation, Extraktion und erste Entwürfe lohnt sich zunächst ein Test günstiger Modelle. Bei teuren Fehlern kommen leistungsstärkere Konfigurationen infrage.
- Die genaue Konfiguration vergleichen. Innerhalb einer Modellfamilie können Punktzahl und Kosten stark variieren. Modellvariante, Anbieter und Cache-Einstellungen gehören ins Testprotokoll.
- Kosten pro erfolgreicher Aufgabe messen. Repräsentative Anfragen, eigene Qualitätskriterien, Wiederholungen, Tool-Aufrufe und Latenz liefern eine belastbarere Entscheidungsgrundlage. Der günstigste Benchmark-Wert muss nicht zum günstigsten zuverlässigen Ergebnis führen.
Artificial Analysis eignet sich gut für eine erste Auswahl nach Leistung und Kosten. Vor dem produktiven Einsatz sollten Teams die aktuellen Werte prüfen und ihre eigenen Aufgaben in einem kleinen Testlauf auswerten.