Modèles d’IA en 2026 : scores et coûts selon Artificial Analysis
Données vérifiées le 24 octobre 2026 · Artificial Analysis Intelligence Index v4.3.2. Pour choisir un modèle, les développeurs ont besoin de regarder à la fois ses capacités et son coût. Artificial Analysis publie un indice de capacité ainsi que le coût API estimé des tâches utilisées pour l’évaluer. La sélection ci-dessous n’est pas un classement exhaustif ; les chiffres peuvent évoluer sur le classement en direct.
Que signifient le score et le coût ?
L’Intelligence Index regroupe dix évaluations couvrant les tâches d’agent, la programmation, les connaissances générales et le raisonnement scientifique. Dans la version 4.3.2, ces quatre catégories pèsent respectivement 30 %, 20 %, 30 % et 20 %. Les épreuves portent surtout sur des tâches textuelles en anglais ; les entrées image et les capacités multilingues sont évaluées séparément. Un score de 50 ne signifie pas 50 % de réussite. Les tranches « 30 », « 40 » et « 50 » facilitent la lecture, mais ne correspondent pas à des niveaux officiels. Consulter la méthodologie.
Le « coût par tâche » est le coût API moyen pondéré, en dollars américains, d’une tâche de l’Intelligence Index. Il tient compte des tokens réellement consommés en entrée, en cache et en sortie, ainsi que de leurs tarifs. Ce n’est pas le prix fixe d’une requête dans votre produit : un agent qui travaille longtemps, un échange bref et une application qui réutilise son cache auront des coûts différents. Consulter la définition du coût.
Aperçu des scores et des coûts
Le niveau de raisonnement indiqué entre parenthèses compte : le modifier peut changer le score et le coût d’un même modèle.
Au-dessus de 50 : pour les flux de travail exigeants
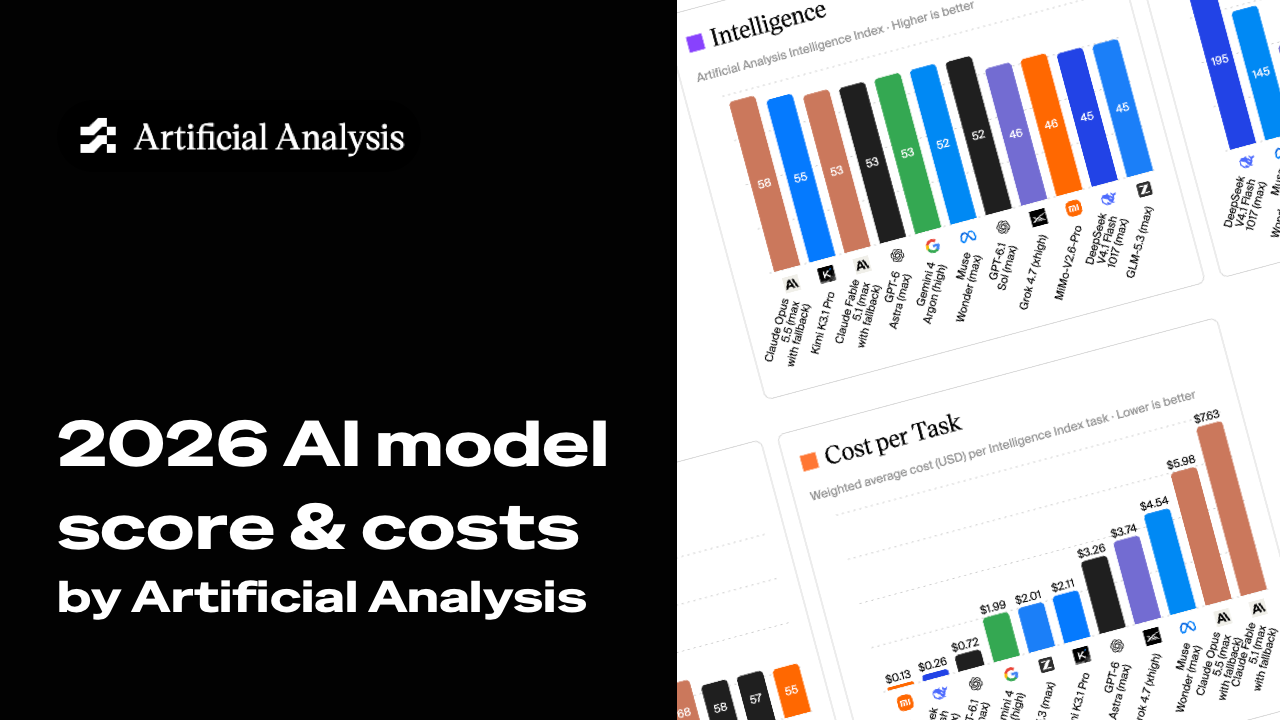
- Claude Opus 5.5 (max, fallback par défaut) : 58 points ; 5,98 $ par tâche. Le meilleur score de cette sélection, avec un coût d’évaluation élevé.
- Claude Sonnet 5.5 (max, fallback par défaut) : 56 points ; 5,46 $ par tâche. Même un modèle « Sonnet » n’est pas forcément économique au niveau de raisonnement maximal.
- Kimi K3.1 Pro : 55 points ; 2,11 $ par tâche. Un score proche des deux précédents pour un coût mesuré inférieur. Ses poids n’étaient pas encore publiés lors de l’analyse du lancement du 23 octobre.
- GPT-6 Astra (max) : 53 points ; 3,26 $ par tâche. Son tarif affiché par million de tokens dépasse celui d’Opus 5.5, mais le coût de la tâche évaluée est inférieur : la quantité de tokens utilisée compte aussi.
- GPT-6.1 Sol (max) : 52 points ; 0,72 $ par tâche. Un score supérieur à 50 pour un coût mesuré nettement plus faible.
Dans les 40 et 30 : des points de départ moins coûteux
- GLM-5.3-Flash : 42 points ; 0,28 $ par tâche. Un modèle à poids ouverts dont le coût API mesuré reste bas.
- GPT-6 Luna (high) : 33 points ; 0,03 $ par tâche. Une option à tester pour des tâches simples ou à grand volume.
Ces tranches servent uniquement à présenter les résultats ; Artificial Analysis ne les utilise pas comme niveaux de certification. Muse Wonder Full (max) obtient aussi 56 points, mais n’a pas de coût par tâche directement comparable, car son prix n’est pas calculé par token. Lire le rapport.
Comment utiliser cette liste en développement ?
- Partir du travail réel. Pour classer, extraire des données ou produire un premier brouillon, tester d’abord un modèle peu coûteux. Réserver les configurations plus puissantes aux tâches où une erreur coûte cher.
- Comparer les configurations exactes. Les niveaux de raisonnement d’une même famille peuvent avoir des scores et des coûts très différents. Noter la variante, le fournisseur et les paramètres de cache.
- Mesurer le coût par tâche réussie dans votre application. Rejouer des requêtes représentatives, vérifier la qualité selon vos critères et compter les relances, les appels d’outils et la latence. La tâche la moins chère dans un benchmark n’est pas toujours le résultat fiable le moins cher en production.
Artificial Analysis fournit un bon point de départ pour comparer capacité et coût. Avant une mise en production, mieux vaut revérifier les données en direct et lancer une petite évaluation sur vos propres tâches.